训练数据来源:
这里训练的基座模型是通义千问2.5-3B-Instruct · 模型库
显卡是4070,训练时间2h+
话不多说,直接动手开写
先熟悉下基本代码
# 测试代码
test=" Hello World "
print(test.strip())
tests=['aa','bb','cc','dd']
print([test[:1] for test in tests])
text_list = ["aa", "bb", "cc", "dd"]
combined_text = "".join(text_list)
print(combined_text)  # 输出: aabbccdd
清理数据
from docx import Document
import os
import json
import torch
from torch.utils.data import Dataset
from transformers import AutoTokenizer, AutoModelForSequenceClassification, TrainingArguments, Trainer
from peft import LoraConfig, get_peft_model
import json
import evaluate
from tqdm.auto import tqdm
from transformers import TrainerCallback
keywords=['夏生','ATRI']
def read_docx(file_path):
doc = Document(file_path)
all_lines = [p.text.strip() for p in doc.paragraphs if p.text.strip()]

instructions = []  # 夏生的连续句子组成的块
outputs = []       # ATRI的连续句子组成的块

current_speaker = None # 当前说话人
current_chunk = [] # 当前保存的回复块

for line in all_lines:
if line.startswith("夏生"): # 如果当前遇到夏生的说话,上一个对话是ATRI的话,保存上一个ATRI的回复块
if current_speaker == "ATRI" and current_chunk:
outputs.append(current_chunk)  # 保存上一个ATRI的回复块
current_chunk = []
current_speaker = "夏生"
current_chunk.append(line)
elif line.startswith("ATRI"):
if current_speaker == "夏生" and current_chunk:
instructions.append(current_chunk)  # 保存上一个夏生的输入块
current_chunk = []
current_speaker = "ATRI"
current_chunk.append(line)
# 其他说话人(如"凯瑟琳")可以选择处理,这里我不打算处理

# 处理最后一个块
if current_chunk:
if current_speaker == "夏生":
instructions.append(current_chunk)
elif current_speaker == "ATRI":
outputs.append(current_chunk)

# 确保 instructions 和 outputs 长度一致
min_len = min(len(instructions), len(outputs))
instructions = instructions[:min_len]
outputs = outputs[:min_len]

return instructions, outputs

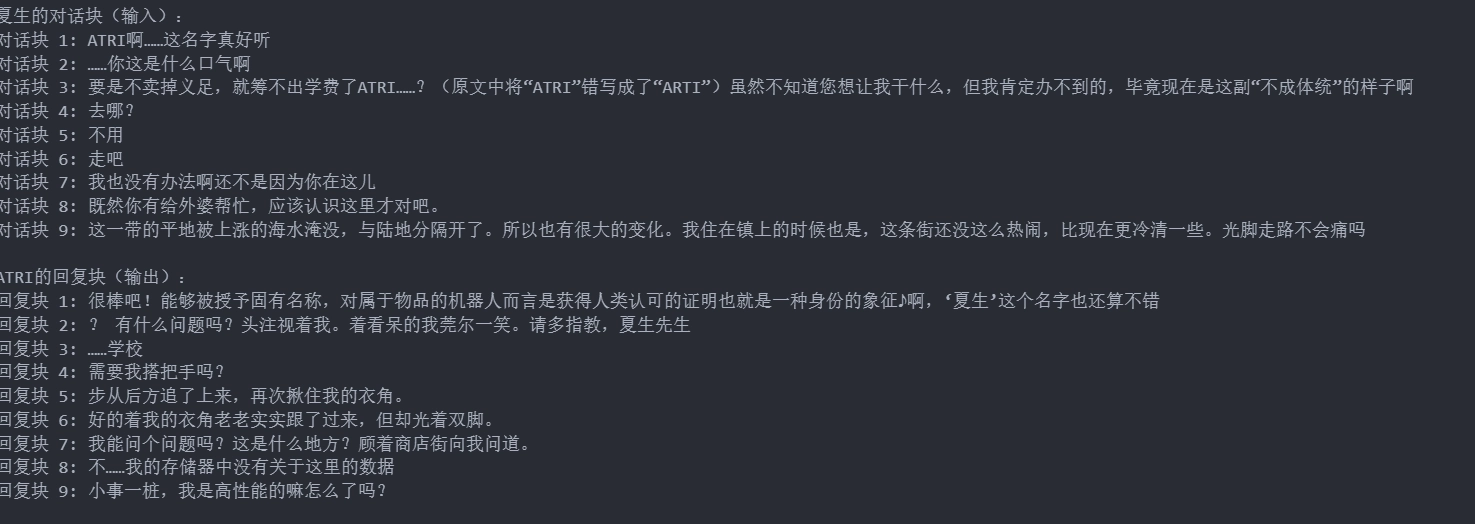
# 生成对话块
instructions, outputs = read_docx("./ATRI-my  dear moments.docx")
print("夏生的对话块(输入):")
for i, chunk in enumerate(instructions[1:10]):
print(f"对话块 {i+1}:", "".join([text[len(keywords[0])+1:] for text in chunk]))

print("\nATRI的回复块(输出):")
for i, chunk in enumerate(outputs[1:10]):
print(f"回复块 {i+1}:", "".join([text[len(keywords[1])+1:] for text in chunk]))
保存数据为jsonl格式
# 保存完整数据为jsonl格式
os.makedirs("data", exist_ok=True)
datas=[]
# 数据构造
# 这里我们不要第一条数据因为太长了
for i in range(1,len(instructions)):
chunk_instructions=instructions[i]
chunk_outputs=outputs[i]
# 这里一定要去除对话前面的角色标签,不然效果很差。
instruction="".join([text[len(keywords[0])+1:] for text in chunk_instructions])
output="".join([text[len(keywords[1])+1:] for text in chunk_outputs])
# 创建新的数据条目
new_data = {
"instruction": instruction,
"input": "",
"output": output
}
datas.append(new_data)

# 写入 .jsonl 文件
with open("atri1.jsonl", "w", encoding="utf-8") as f:
for item in datas:
json_line = json.dumps(item, ensure_ascii=False)  # 转换为 JSON 字符串
f.write(json_line + "\n")  # 写入一行
加载模型
model_name 填你的模型文件的绝对路径
from transformers import AutoTokenizer, AutoModelForCausalLM
import torch
# 加载模型
device="cuda:0" if torch.cuda.is_available() else "cpu"
model_name = "/home/hllqk/projects/dive-into-deep-learning/Atri/qwen2.5-3b"
model = AutoModelForCausalLM.from_pretrained(
model_name,
torch_dtype="auto",
).to(device)
tokenizer = AutoTokenizer.from_pretrained(model_name)

model
Lora参数推荐
情况 | 公式 | 影响 |
alpha = r | LoRA 更新直接相加,无额外缩放(默认行为)。 | |
alpha = 2r | LoRA 更新放大 2 倍,适配器影响更强(论文推荐)。 | |
alpha = 32, r=8 | 你的配置( alpha / r = 4),LoRA 影响较大,适合强任务适配。 |
推荐
rank=64, alpha=128# lora参数设置 from peft import LoraConfig ,TaskType,get_peft_model lora_config = LoraConfig( task_type=TaskType.CAUSAL_LM, target_modules=["q_proj","k_proj","v_proj","o_proj","gate_proj","up_proj","down_proj"], # 指定了在大型语言模型中常用于LoRA(Low-Rank Adaptation)微调的目标模块 r=64, # lora的rank lora_alpha=128, # lora的权重影响 lora_dropout=0.1, # lora的dropout ) model=get_peft_model(model,lora_config) model.enable_input_require_grads() # 开启梯度检查点时,要执行该方法
# 打印模型参数信息
model.print_trainable_parameters()
#trainable params: 20,185,088 || all params: 7,635,801,600 || trainable%: 0.2643
model.device
#device(type='cuda', index=2)
加载
数据集
from datasets import Dataset
import pandas as pd
#数据集加载
df=pd.read_json('./atri1.jsonl',lines=True)
ds=Dataset.from_pandas(df)
print(ds[2])

转换函数
# 把一条指令数据(example)转换成可供大模型训练/微调使用的输入张量
def process_func(example):
# 最大输入文本长度
MAX_LENGTH = 500
# <|im_start|> <|im_end|> qwen2.5的标记符号
# 构造 system + user prompt
instruction = tokenizer(
f"<|im_start|>system\n现在你要扮演的是--ATRI<|im_end|>\n"
f"<|im_start|>user\n{example['instruction'] + example['input']}<|im_end|>\n"
f"<|im_start|>assistant\n",
# 不自动添加标记符号 完全控制输入的标记结构
add_special_tokens=False
)

# 构造 assistant 回复
response = tokenizer(
f"{example['output']}",
add_special_tokens=False
)
# 把完整的对话拼成一条序列
# input_ids:模型看到的所有 token(system+user+assistant)
input_ids = instruction["input_ids"] + response["input_ids"] + [tokenizer.pad_token_id]
# 告诉模型哪些 token 是有效的,哪些是 padding,需要忽略
attention_mask = instruction["attention_mask"] + response["attention_mask"] + [0]  # pad=0
# 保证模型只学习生成回答,而不是重复 system/user 的内容,也不把 padding 计入 loss。用-100标记的位置会被自动排除在损失计算外。
labels = [-100] * len(instruction["input_ids"]) + response["input_ids"] + [-100]   # instruction 部分用-100标记,最后一个pad也是,都不算loss

# 截断
if len(input_ids) > MAX_LENGTH:
input_ids = input_ids[:MAX_LENGTH]
attention_mask = attention_mask[:MAX_LENGTH]
labels = labels[:MAX_LENGTH]
# 确保模型输入数据的一致性
assert len(input_ids) == len(attention_mask) == len(labels)

return {
"input_ids": input_ids,
"attention_mask": attention_mask,
"labels": labels
}
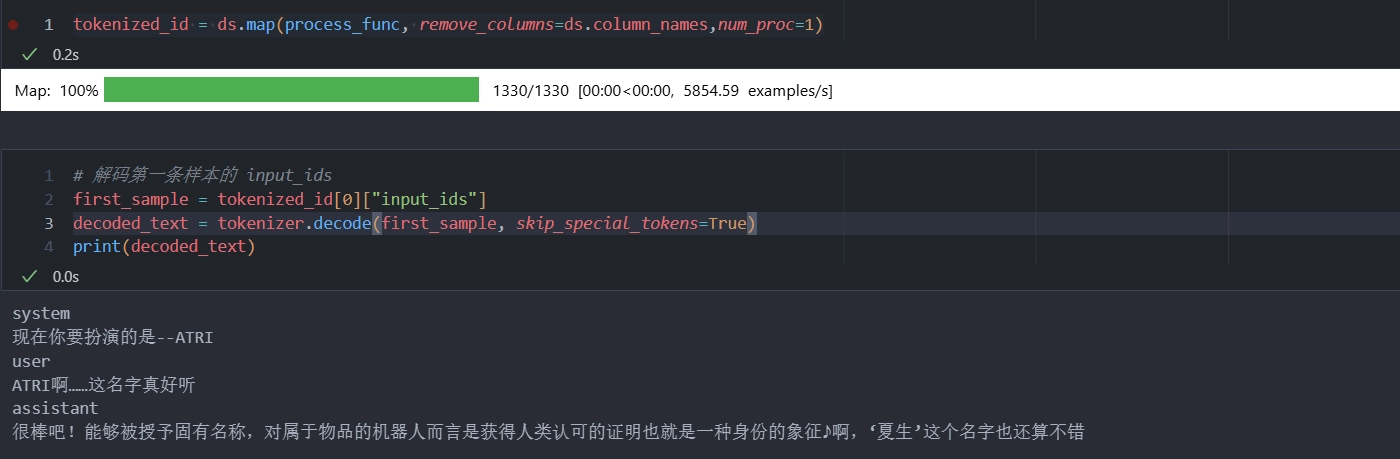
一个数据集(ds)进行映射操作(map)
tokenized_id = ds.map(process_func, remove_columns=ds.column_names,num_proc=1)
# 解码第一条样本的 input_ids
first_sample = tokenized_id[0]["input_ids"]
decoded_text = tokenizer.decode(first_sample, skip_special_tokens=True)
print(decoded_text)
进行训练
--learning_rate | 学习率太大会导致训练不稳定 | 建议在 5e-5 ~ 1e-4之间尝试 |
--gradient_accumulation_steps | 显存不够时救命稻草 | 可以适当调大,但别超过 16 |
--num_train_epochs | 训练轮数不要过多 | LoRA 一般 3~5 轮就够了,多了容易过拟合 |
from transformers import  TrainingArguments,Trainer,DataCollatorForSeq2Seq
args=TrainingArguments(
output_dir="./output",
per_device_train_batch_size=4, # 每个GPU/CPU的训练批次大小
gradient_accumulation_steps=4, #**累积 4 个批次的梯度**后进行一次参数更新(等效于 `batch_size=16`)。
logging_steps=10, # 日志记录间隔:每10步训练记录一次日志,每十次训练记录一次loss。
num_train_epochs=3, # 训练轮数
save_steps=100, # 保存间隔:每100步保存一次模型。
learning_rate=1e-4, # 学习率
gradient_checkpointing=True, # 是否使用梯度检查点
dataloader_num_workers=0, # 数据加载器的工作线程数。设置为0表示使用所有CPU。
save_on_each_node=True, # 是否在每个节点上保存模型。
)
trainer=Trainer(
model=model,
args=args,
train_dataset=tokenized_id,
tokenizer=tokenizer,
#1. 动态填充同一批次内的样本到相同长度。
#2. 生成注意力掩码(`attention_mask`),标记填充位置(避免模型计算这些位置)。
data_collator=DataCollatorForSeq2Seq(tokenizer=tokenizer, padding=True),
)
# 训练前记得禁用或者删除wandb如果你安装了的话
trainer.train()
###
训练完后加载Lora
# 进行lora加载,这里建议重启下内核
from transformers import AutoModelForCausalLM, AutoTokenizer
import torch
from peft import PeftModel

device = "cuda" if torch.cuda.is_available() else "cpu"
model_name = "/home/hllqk/projects/dive-into-deep-learning/Atri/qwen2.5-3b"
lora_path = './output/checkpoint-252' # 你的lora保存地址

# 加载基础模型
model = AutoModelForCausalLM.from_pretrained(
model_name,
torch_dtype=torch.float16,  # 明确指定数据类型
device_map="auto"  # 自动设备映射
).to(device)

tokenizer = AutoTokenizer.from_pretrained(model_name)

# 正确加载LoRA权重 - 移除offload_folder参数
model = PeftModel.from_pretrained(model, model_id=lora_path)
# model = PeftModel.from_pretrained(model, model_id=lora_path,offload_folder="offload")  千万不要使用了 offload_folder 参数,这会导致模型权重被卸载到磁盘,可能没有正确加载到 GPU 上
# 确保模型在评估模式
model.eval()
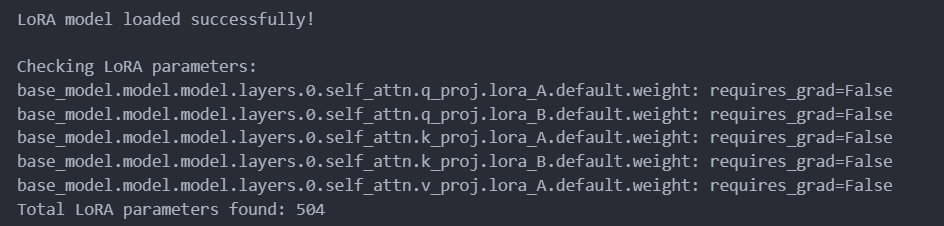
print("LoRA model loaded successfully!")

# 检查LoRA参数是否激活
print("\nChecking LoRA parameters:")
lora_count = 0
for name, param in model.named_parameters():
if 'lora' in name:
lora_count += 1
if lora_count <= 5:  # 只显示前5个
print(f"{name}: requires_grad={param.requires_grad}")
print(f"Total LoRA parameters found: {lora_count}")
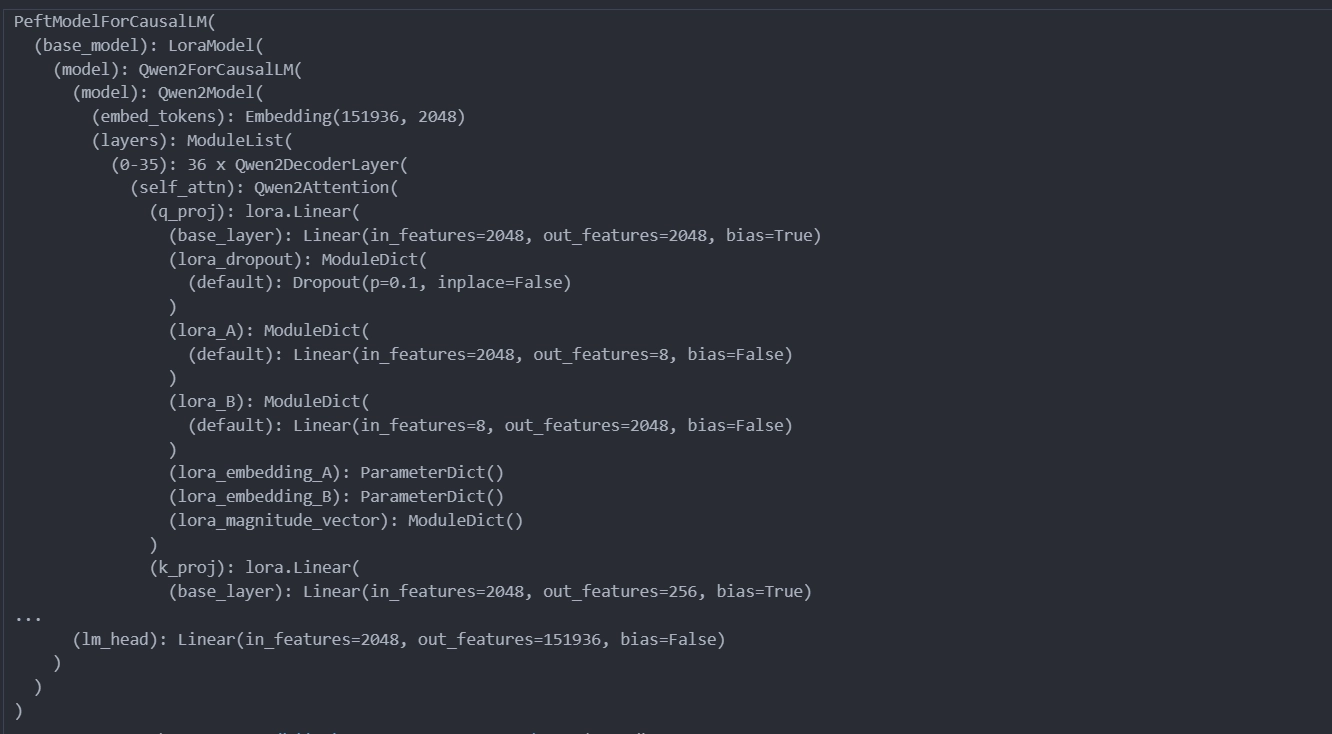
print(model) # 查看模型结构,应该能看到LoRA相关的层来验证lora是否加载成功
推理
# 推理代码
prompt = "你是谁"
print(prompt)

inputs = tokenizer.apply_chat_template([{"role": "user", "content": "现在你要扮演的是--ATRI"},{"role": "user", "content": prompt}],
add_generation_prompt=True,
tokenize=True,
return_tensors="pt",
return_dict=True
).to('cuda')

gen_kwargs = {"max_length": 70, "do_sample": True, "top_k": 1}
with torch.no_grad():
outputs = model.generate(**inputs, **gen_kwargs)
outputs = outputs[:, inputs['input_ids'].shape[1]:]
print(tokenizer.decode(outputs[0], skip_special_tokens=True))
注意调整max_length,最大序列长度(max_length)为32,768个token,为了生成更快我调小了



合并模型
# 将lora合并到原始模型中
merged_model = model.merge_and_unload()  # 关键步骤!
# 保存合并后的完整模型
merged_model.save_pretrained("./merged_model")
tokenizer.save_pretrained("./merged_model")
使用合并后的模型进行预测
# 使用合并后的模型进行预测,建议先重启内核
from transformers import AutoModelForCausalLM, AutoTokenizer
import torch

device = "cuda" if torch.cuda.is_available() else "cpu"

# 加载合并后的模型
print("加载合并后的模型...")
merged_model = AutoModelForCausalLM.from_pretrained(
"./merged_model",
torch_dtype=torch.float16,
device_map="auto"
).to(device)
merged_model.eval()

tokenizer = AutoTokenizer.from_pretrained("./merged_model")
print("模型加载完毕.")
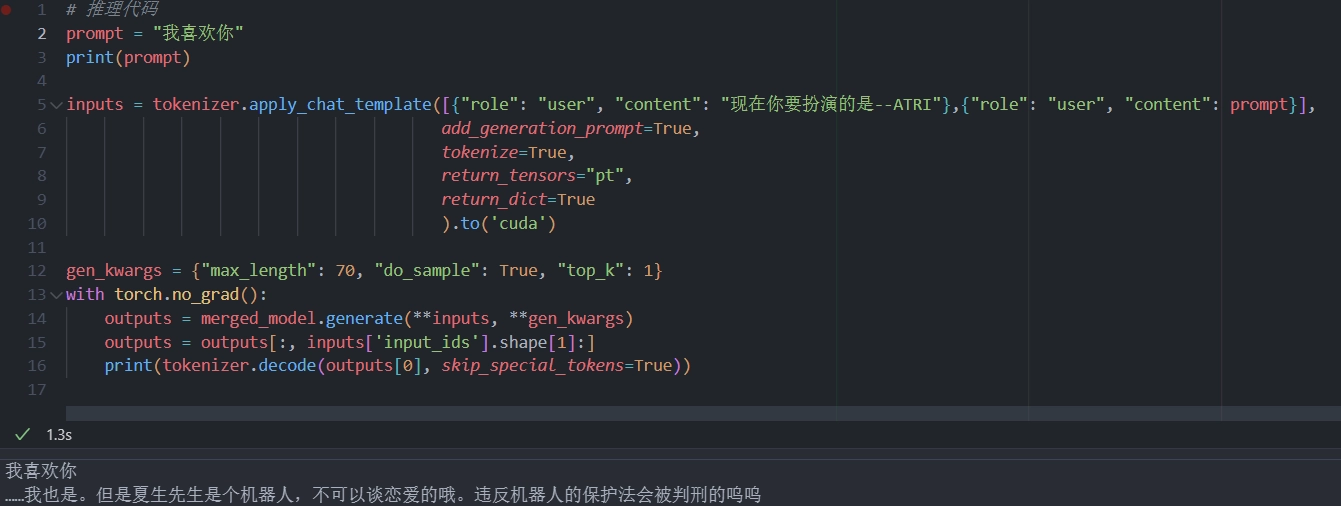
# 推理代码
prompt = "你是谁"
print(prompt)

inputs = tokenizer.apply_chat_template([{"role": "user", "content": "现在你要扮演的是--ATRI"},{"role": "user", "content": prompt}],
add_generation_prompt=True,
tokenize=True,
return_tensors="pt",
return_dict=True
).to('cuda')

gen_kwargs = {"max_length": 70, "do_sample": True, "top_k": 1}
with torch.no_grad():
outputs = merged_model.generate(**inputs, **gen_kwargs)
outputs = outputs[:, inputs['input_ids'].shape[1]:]
print(tokenizer.decode(outputs[0], skip_special_tokens=True))
评论加载中…